SerpApi adopte le Markdown comme format par défaut pour ses API de recherche
SerpApi, fournisseur de données de recherche depuis neuf ans, a déployé une sortie Markdown sur l'ensemble de ses 100+ API sans surcoût, selon The Next Web. Ce format, plus économe en tokens que le JSON, s'impose comme le standard d'échange entre les données web et les modèles d'intelligence artificielle.
Dans cet article
Un format déjà maîtrisé par les modèles
Le Markdown s'installe progressivement comme le format de sortie par défaut pour tout contenu destiné à être lu par un modèle d'intelligence artificielle, en remplacement du JSON, longtemps utilisé comme format universel, selon The Next Web. Ce basculement s'explique par la manière dont les grands modèles de langage sont entraînés : ils ont ingéré d'énormes volumes de documentation, de fichiers README, de blogs techniques et de fils de discussion, et reconnaissent donc naturellement les titres, listes, tableaux et blocs de code comme des signaux sémantiques.
Les interfaces de dialogue savent déjà afficher des réponses en Markdown, sans transformation supplémentaire. Un modèle qui reçoit ce format retrouve une structure proche de sa distribution d'entraînement, ce qui simplifie l'aller-retour entre l'entrée et la sortie. À l'inverse, un JSON dense et imbriqué doit être décodé avant d'être exploité.
La question du coût en tokens
L'argument économique est central. Le Markdown élimine la surcharge structurelle tout en conservant l'information utile. Pour les agents d'IA qui doivent faire tenir un large contexte dans une fenêtre limitée, ce gain se traduit directement par davantage de contenu pertinent par requête et un coût d'inférence réduit.
Cette évolution n'est pas théorique. La documentation d'OpenAI sur l'ingénierie des prompts recommande explicitement d'organiser les messages avec des en-têtes Markdown, des listes à puces et des tableaux, en utilisant « ## » pour les sections principales et des backticks pour le code. Des guides tiers reprennent la même logique, en soulignant que ce format est plus économe en tokens et mieux compris par les modèles entraînés sur de la documentation.
SerpApi généralise la sortie Markdown
Les fournisseurs de données ont adopté la même approche. SerpApi, société spécialisée dans les API de données de recherche depuis neuf ans, a lancé une sortie Markdown sur l'ensemble de ses 100+ API, sans coût additionnel. L'entreprise fournit des informations structurées issues de Google, Bing, YouTube et d'autres sources à des développeurs, des chercheurs et des entreprises du Fortune 500.
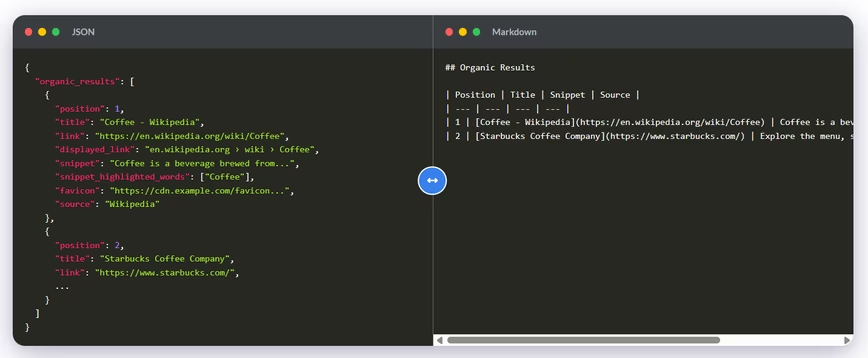
La fonctionnalité permet de demander des résultats de recherche dans un format Markdown allégé en tokens plutôt qu'en JSON, à destination des agents d'IA et des applications fondées sur les LLM. Aucun nouvel endpoint n'est nécessaire : le format se demande via un paramètre de requête, une extension de route ou un en-tête, sur les intégrations existantes.
Jusqu'à 74 % de tokens en moins sur une recherche
Les mesures publiées par SerpApi donnent un ordre de grandeur. Une recherche Google unique pour « coffee » coûte 24 723 tokens en JSON contre 6 435 en Markdown, soit une réduction de 74 %. En ajoutant un filtrage des champs, la même réponse tombe à 1 298 tokens. Sur l'ensemble de ses API, la société rapporte des économies moyennes d'environ 50 %, certains endpoints atteignant jusqu'à 90 %.
Ces chiffres comptent parce que les résultats de recherche figurent parmi les contenus les plus volumineux et les plus imbriqués que traitent les agents. Les réponses JSON transportent des liens de redirection, des favicons, des paramètres de suivi et des métadonnées profondes dont les modèles n'ont pas besoin. La sortie Markdown conserve l'essentiel — titres, extraits, liens, prix, notes — dans des tableaux et des listes, tout en écartant une partie du bruit interne et des champs dupliqués.
Comment y accéder
Les développeurs peuvent obtenir ce format en ajoutant « output=md » à la chaîne de requête, en appelant la route « /search.md » ou en définissant un en-tête « Accept: text/markdown ». Les réponses comportent un frontmatter YAML pour les métadonnées, des tableaux Markdown structurés pour les jeux de résultats et des liens inline natifs, conçus pour être insérés directement dans un prompt ou la mémoire d'un agent.
Vers une standardisation des échanges
À mesure que les agents consomment une part croissante du web à la place des humains, la couche d'infrastructure s'optimise pour la lisibilité machine plutôt que pour l'imbrication confortable pour l'humain. Le JSON reste indispensable pour la manipulation programmatique et l'application stricte de schémas, mais le Markdown s'impose pour la phase d'ingestion de contexte dans les flux de travail d'IA.
Cette tendance devrait se poursuivre : davantage de fournisseurs de données proposeront des variantes Markdown, en particulier pour la recherche, le commerce en ligne, la cartographie et les API de contenu, où l'efficacité en tokens a un effet immédiat sur le coût et la performance. Les modèles de prompts et les frameworks d'agents devraient également standardiser l'usage des sections, tableaux et listes Markdown pour présenter le contexte récupéré aux modèles.