OpenAI : Richard Ho explique comment l'IA a modifié la puce Jalapeño
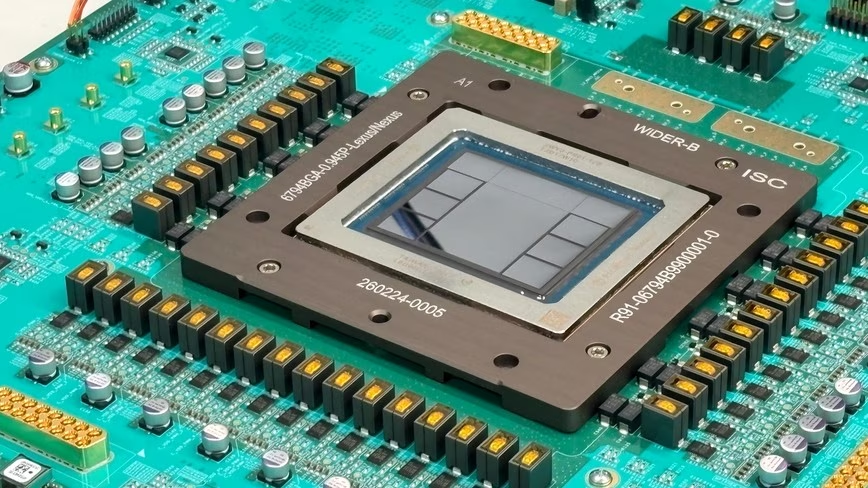
Richard Ho, responsable du matériel chez OpenAI, raconte comment les modèles internes de l'entreprise ont modifié des parties de la puce Jalapeño sans que ses ingénieurs comprennent toujours pourquoi. La deuxième version du composant est en cours de qualification en laboratoire, alors qu'OpenAI se rapproche de la production en volume.
Dans cet article
Des modèles internes au cœur de la conception de la puce Jalapeño
Chez OpenAI, les modèles d'intelligence artificielle de l'entreprise ont réécrit des portions de sa puce Jalapeño sans que ses ingénieurs sachent toujours expliquer ces choix. Dans un cas cité, ils ont permis d'économiser plus de 13 % de la surface du die, rapporte The Next Web, citant un entretien de Richard Ho avec Ian Cutress, de More Than Moore, publié le 30 septembre.
Richard Ho dirige l'équipe matérielle d'OpenAI. « Eh bien, je ne leur fais toujours pas confiance à 100 % », a-t-il déclaré à More Than Moore.
OpenAI avait dévoilé sa propre puce en juin. Conçue avec Broadcom, elle est destinée à faire tourner les modèles de l'entreprise, non à les entraîner. Lors de la conférence Hot Chips en août, OpenAI a présenté des résultats de benchmark face au GB300 de Nvidia. L'entretien porte, lui, sur la fabrication du composant. Richard Ho a rejoint OpenAI en 2023, après avoir été l'un des premiers ingénieurs du programme TPU de Google et, avant cela, avoir travaillé sur les supercalculateurs Anton chez D.E. Shaw Research.
Des ajustements non expliqués, mais validés
L'équipe a avancé vite, selon Richard Ho. Ses premières estimations de la quantité de logique pouvant tenir sur la puce se sont révélées un peu fausses. Plutôt que de sacrifier des performances, elle a confié le problème à ses modèles. À l'époque, précise-t-il, il s'agissait de modèles internes bruts, non affinés pour le travail de conception de puces, et seulement légèrement en avance sur ce que le grand public pouvait utiliser.
Une grande partie du code traité par les modèles était écrite en XLS, un outil qui transforme du code de haut niveau en logique de puce. Chris Leary, aujourd'hui dans l'équipe de Richard Ho, l'avait publié en open source lorsqu'il était chez Google. Ce langage se lit davantage comme du Rust que comme le Verilog utilisé pour la plupart des puces. Les modèles se débrouillant mieux avec du logiciel qu'avec du Verilog, XLS leur permettait de raisonner sur la conception, explique Richard Ho.
Certaines modifications apportées au code source par les modèles n'avaient pas d'explication claire. L'équipe allait trop vite pour s'arrêter et déterminer pourquoi elles étaient utiles, indique-t-il.
« Nous ne comprenions pas vraiment conceptuellement ce qu'il faisait », a-t-il dit.
Chaque changement est donc passé par le processus complet de validation, et les outils de conception standards continuent de valider la puce. Une puce peut comporter des centaines de millions de portes logiques : un modèle juste à 99,99 % ne suffit pas à ce niveau, selon Richard Ho. Il qualifie ce risque de raisonnable, à condition que l'équipe reste prudente. Il ne réduira pas ses effectifs à cause des modèles, ajoute-t-il : il les utilisera pour faire davantage, plus vite.
Un choix d'architecture assumé
Richard Ho défend aussi le parti pris le plus inhabituel de la puce. Une grande partie du secteur répartit désormais l'inférence sur des matériels distincts selon l'étape : le prefill, qui lit la requête, et le decode, qui rédige la réponse.
OpenAI a conçu une seule partie pour l'ensemble. Verrouiller la capacité d'un centre de données sur un ratio fixe devient risqué quand la répartition des charges évolue sans cesse, souligne Richard Ho. Il reconnaît que cette architecture pourrait entraîner un coût qui n'apparaîtra qu'en déploiement réel, et que les contextes très longs pourraient rencontrer des limites.
La puce relie directement des bancs de mémoire à haut débit à ses cœurs, ce qui réduit les déplacements de données. Richard Ho s'attend à ce que ses concurrents, fabricants de GPU compris, copient cette idée. OpenAI a malgré tout choisi de la publier, alors que l'entreprise figure parmi les plus gros clients de Nvidia.
« Parce que nous avons encore besoin de GPU, et que nous voulons que les GPU progressent », a-t-il déclaré.
À ses yeux, la véritable limite du secteur n'est ni la puissance, ni la mémoire, ni le packaging. Elle tient au fait que dirigeants et investisseurs, échaudés par les cycles précédents, n'imaginent pas l'ampleur que prendra l'IA, et prennent donc des paris trop modestes. La deuxième version de Jalapeño est désormais en laboratoire pour qualification, tandis qu'OpenAI se dirige vers la production en volume.


