HAIDI et ADDN veulent combler le déficit de données sur le handicap en Afrique
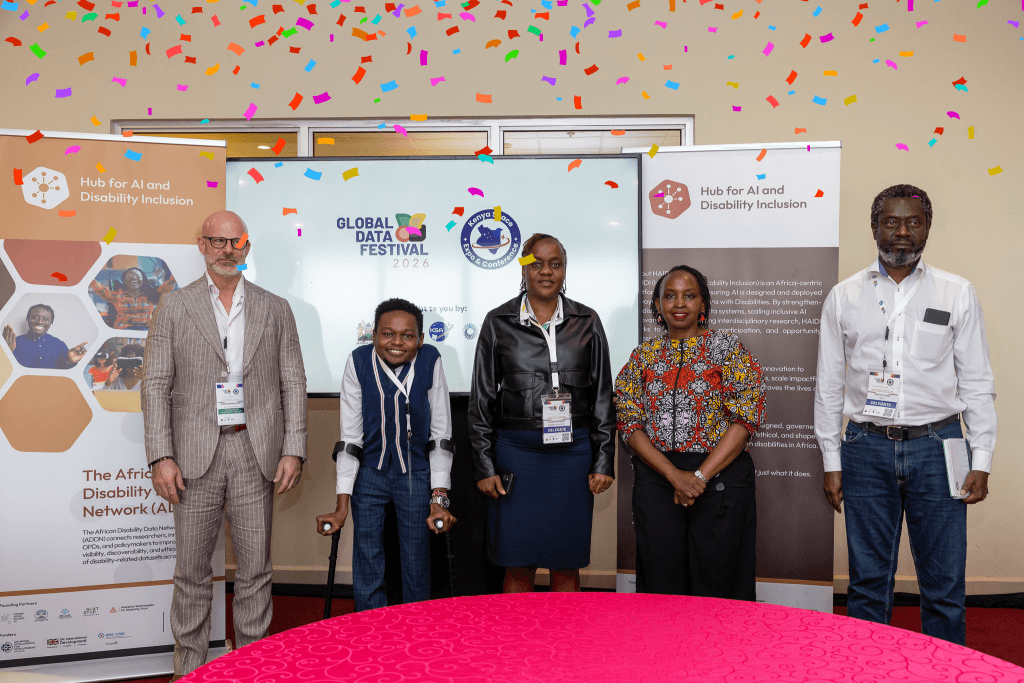
Le Hub for AI and Disability Inclusion (HAIDI) et l'African Disability Data Network (ADDN) ont été dévoilés au Global Data Festival de Nairobi pour renforcer l'infrastructure de données nécessaire à une IA inclusive en Afrique. Portés par un consortium soutenu par le CRDI, le FCDO britannique et le programme AI4D, ils visent à cartographier les jeux de données existants et à en créer de nouveaux.
Dans cet article
Un déficit de données qui pénalise les personnes handicapées
En Afrique, plus d'une personne sur huit vit avec un handicap significatif dans les 47 pays de la Région africaine de l'Organisation mondiale de la santé (OMS), d'après le Rapport mondial de 2022 de l'OMS sur l'équité en santé pour les personnes handicapées. Pourtant, ces populations restent sous-représentées dans les données servant à entraîner les systèmes d'intelligence artificielle.
Une étude exploratoire commandée en 2025 par Artificial Intelligence for Development (AI4D), menée au Ghana, au Kenya et au Rwanda auprès de plus de 585 participants, a mis en évidence cette sous-représentation, ainsi que la fragmentation et le mauvais référencement des données existantes sur le handicap. C'est ce constat qui a conduit des chercheurs et des défenseurs des droits des personnes handicapées à lancer le Hub for AI and Disability Inclusion (HAIDI) et l'African Disability Data Network (ADDN), rapporte TechCabal.
Deux structures aux rôles complémentaires
Présentées lors du Global Data Festival à Nairobi, les deux initiatives bénéficient du soutien du Centre de recherches pour le développement international (CRDI), du Foreign, Commonwealth and Development Office (FCDO) britannique et du programme AI4D. Elles reposent sur un partenariat entre le Responsible AI Lab (RAIL) de l'université Kwame Nkrumah de science et technologie (KNUST) au Ghana, la Next Step Foundation, l'Assistive Technologies for Disability Trust (AT4D) et le Centre for Applied AI (MCAAI) de l'université Maseno.
Hébergé par le RAIL de la KNUST, HAIDI joue le rôle de hub continental réunissant communautés de personnes handicapées, chercheurs, innovateurs, décideurs et institutions. Ses travaux portent sur le renforcement des systèmes de données centrés sur le handicap, le soutien à l'innovation en IA inclusive, la recherche et la gouvernance éthique de l'IA.
ADDN, l'une des initiatives opérant dans cet écosystème, ne fonctionne pas comme un entrepôt central. Elle a été conçue comme un réseau de coordination et de découverte permettant aux chercheurs, startups, décideurs et institutions d'identifier les jeux de données liés au handicap et de se mettre en relation avec les organisations qui les gèrent.
« ADDN est conçu pour rendre les jeux de données liés au handicap plus faciles à découvrir et à naviguer, plutôt que de stocker toutes les données au même endroit », a expliqué le consortium à TechCabal. « Pour les startups et les innovateurs, l'un des principaux obstacles au développement de solutions d'IA inclusives est simplement de savoir quels jeux de données existent déjà et qui les gère. »
Concrètement, un chercheur développant un outil de traduction en langue des signes assisté par IA pourrait utiliser ADDN pour vérifier si un jeu de données pertinent existe, identifier l'institution qui le gère et demander un accès directement auprès d'elle, selon son propre cadre de gouvernance et de consentement. Le réseau agit ainsi comme un pont entre ceux qui ont besoin de données et ceux qui les détiennent, limitant les duplications et favorisant la collaboration entre pays et institutions.
Cartographier un « désert de données »
L'un des premiers objectifs du hub est de répondre à une question simple : quelles données sur le handicap existent déjà en Afrique ? Le consortium reconnaît ne pas encore le savoir. L'étude commandée par AI4D a relevé des lacunes pour les langues des signes africaines et les langues locales. Les données en langue des signes kényane sont par exemple très limitées comparées à celles en langue des signes américaine, tandis que les données vocales en kinyarwanda impliquant des troubles de la parole sont quasi inexistantes dans les jeux de données mondiaux.
« Cette étude est ce qui a fait apparaître le désert de données sur le handicap », a déclaré le consortium. « Elle nous a dit que l'écart existe et pourquoi, mais ce n'était pas un inventaire complet de tous les jeux de données existants. Donc non, nous n'avons pas encore de décompte définitif, et combler cet écart est précisément ce que l'agenda de recherche de HAIDI est construit pour faire ensuite. »
La prochaine étape débute par un exercice d'inventaire et de cartographie à l'échelle du continent, l'une des priorités de HAIDI pour sa première année. Les chercheurs identifieront les jeux de données liés au handicap dans des domaines comme la langue des signes, la parole et la santé, documenteront où ils sont conservés et détermineront où se situent les principaux écarts selon les langues, les types de handicap, les zones géographiques et les modalités de données.
Le consortium signale aussi que des formats d'annotation incohérents peuvent rendre ces jeux de données difficiles à combiner ou à exploiter pour l'apprentissage automatique. Parallèlement à la cartographie, HAIDI développera trois jeux de données centrés sur l'Afrique : le premier sur les langues des signes, le deuxième sur la santé mentale et la santé sexuelle et reproductive, le troisième sur l'emploi inclusif.
Le jeu de données de santé impliquera initialement des participants âgés de 18 ans et plus, avec une tranche d'âge cible de 18 à 30 ans. Il pourrait ensuite inclure des personnes de 13 à 17 ans, mais seulement après avoir réglé les questions de consentement parental. Les données seront élaborées avec des experts et les communautés concernées, et anonymisées dans la mesure du possible.
Consentement, anonymisation et limites
Créer de nouveaux jeux de données ne suffit pas. Convaincre les personnes de contribuer, en particulier sur des informations intimes, exige des garanties solides en matière de vie privée, de consentement et de gouvernance. Le consortium indique que toute activité impliquant des personnes handicapées fera l'objet d'un examen éthique et d'une approbation des comités d'éthique et des autorités de régulation nationales compétentes. Les participants donneront leur consentement éclairé, leurs données personnelles seront anonymisées autant que possible et stockées de manière sécurisée.
Mais l'anonymisation ne supprime pas tous les risques. Fola Adeleke, expert en gouvernance de l'IA et protection des données, rappelle que la désidentification ne empêche pas toujours une réidentification, selon le type et le volume de données collectées.
« Cela dépend de l'échelle des données et du type de données que vous collectez », a-t-il déclaré. « Certaines métadonnées peuvent ne pas être complètement anonymisables. »
Le consortium précise que les participants auront le droit de retirer leurs données. En cas de retrait, celles-ci seront supprimées du jeu de données publié, mais il reconnaît qu'il serait difficile de retirer des données déjà téléchargées et utilisées pour entraîner des modèles d'IA.
Pour Fola Adeleke, cela rend le consentement d'autant plus important. « Une fois que les données ont servi à entraîner l'IA, il peut être techniquement difficile ou impossible de les retirer sans réentraîner le modèle », a-t-il dit. « Le consentement éclairé est donc crucial avant l'utilisation des données. »
Ces mesures de gouvernance traduisent un principe plus large : les personnes handicapées ne doivent pas être de simples sources de données, mais des participants actifs à la façon dont ces données sont collectées et utilisées.
Représentativité et premiers produits
HAIDI et ADDN disent travailler avec des innovateurs en langue des signes, des organisations de personnes handicapées et des institutions de recherche dans plusieurs pays pour rendre leurs jeux de données plus représentatifs. Ils prévoient aussi de collecter des données ventilées par genre et d'accroître la participation des femmes et des filles handicapées, souvent exclues de la recherche en raison de la stigmatisation sociale et des responsabilités de soins.
Le modèle collaboratif prend déjà forme : le consortium indique mobiliser plus de 80 fondateurs développant des technologies de langue des signes via sa série de webinaires panafricains sur la langue des signes, constituant un premier réseau de chercheurs et d'innovateurs travaillant sur différentes langues des signes africaines.
Pour Abdulazeez Hamdallah, défenseur des droits des personnes handicapées basé à Lagos et malentendant, le besoin de meilleures données locales est visible dans les outils qu'il utilise déjà. Il se sert de ChatGPT, le chatbot d'OpenAI, pour rédiger des rapports et des messages, organiser ses idées et préparer des supports de formation, tout en s'appuyant sur les applications de visioconférence Google Meet et Microsoft Teams pour les sous-titres en direct et sur Otter.ai pour la transcription de réunions.
Mais ces outils ne facilitent pas toujours la communication. Hamdallah explique qu'ils prennent mal en charge la langue des signes et peinent avec les accents, la parole rapide et le bruit de fond.
« Je me suis trouvé dans des réunions et des lieux où je ne comprenais pas ce qui était dit parce que le sous-titrage en direct ne fonctionnait pas correctement à cause de l'accent de la personne », raconte-t-il. « C'est parfois très frustrant. »
C'est l'une des lacunes que le futur jeu de données sur la langue des signes doit combler. Hamdallah estime que les personnes dont les expériences sont collectées devraient aussi participer aux décisions sur la manière dont les données sont recueillies et gérées. « Je pense que c'est une initiative très bonne et importante, surtout si les personnes handicapées sont directement impliquées dans la collecte et la gestion des données », dit-il.
Pour Yinka Olaito, directeur exécutif du Centre for Disability and Inclusion Africa, des initiatives comme HAIDI et ADDN arrivent à un moment crucial. « Cela arrive au bon moment en Afrique, où l'IA devient partie intégrante de tout ce que nous faisons », a-t-il déclaré. « Il est important de penser l'IA sous l'angle de l'inclusion des personnes handicapées, sinon nous continuerons d'avoir de la discrimination autour de la parole et d'autres domaines du handicap, laissant des gens en dehors de technologies qui devraient leur profiter. »
Qualifiant ces initiatives de « bon point de départ », Yinka Olaito estime que beaucoup reste à faire pour que l'écosystème africain de l'IA ne reproduise pas les schémas d'exclusion existants, et que ce lancement doit déclencher une conversation plus large sur le rôle des données sur le handicap dans l'avenir de l'IA sur le continent. « Nous sommes encore confrontés à des défis de accessibilité numérique, de financement et d'infrastructure, mais cela rend d'autant plus important de tirer parti de l'IA d'une manière qui inclut tout le monde », dit-il.
Le consortium veut aussi que ces données se traduisent en produits. En parallèle du lancement de HAIDI et ADDN, il a annoncé un programme de soutien de 18 mois destiné à trois startups développant des solutions d'IA pour les personnes handicapées. Les startups sélectionnées recevront des subventions pouvant atteindre 5 millions de shillings kényans (38 600 dollars), un accompagnement technique et produit, ainsi que des possibilités de tester leurs solutions.